


Restablecer el servicio después de un incidente en producción es la primera prioridad, pero un sistema recuperado no es un sistema validado. Un reinicio, un rollback o más infraestructura pueden devolver los tiempos de respuesta a la normalidad mientras la causa raíz sigue ahí, lista para reaparecer en el próximo pico de tráfico.
En QAlified usamos la evidencia del incidente como punto de partida del trabajo de rendimiento. Los datos recolectados durante la falla guían cómo diseñamos la prueba de carga, dónde buscamos los cuellos de botella y cómo demostramos que una corrección resiste en condiciones reales. A continuación, explicamos cada paso de ese proceso de validación.
¿Cómo planificar las pruebas de carga después de un incidente en producción?
Las pruebas de carga después de un incidente deben reproducir las condiciones que causaron la falla, con datos reales del incidente, cargas de trabajo representativas y un entorno comparable a producción. Luego, los equipos miden los percentiles de tiempo de respuesta, las tasas de error, el throughput y el uso de recursos, y comparan los resultados antes y después de la corrección contra criterios de aceptación acordados de antemano.
En resumen
- Restablecer el servicio no demuestra que el problema de rendimiento esté resuelto; solo lo demuestra una prueba repetible bajo una carga equivalente.
- Empieza por los datos del incidente: TPS, usuarios concurrentes, datos de prueba y los cambios desplegados antes de la falla.
- Prueba las transacciones críticas para el negocio y todas las transacciones que modificó la corrección.
- Mira más allá de los promedios: los percentiles, las tasas de error y las métricas de recursos revelan cuellos de botella que los promedios ocultan.
- Valida la corrección ejecutando la misma prueba antes y después, contra criterios acordados con el negocio.
¿Qué datos del incidente deben guiar el plan de pruebas de carga?
Un plan de pruebas de carga posterior a un incidente debe construirse con evidencia de la propia falla: cuándo ocurrió, con qué carga y después de qué cambios. Una vez estabilizado el servicio, la primera pregunta que hacemos es: ¿en qué condiciones ocurrió el problema?
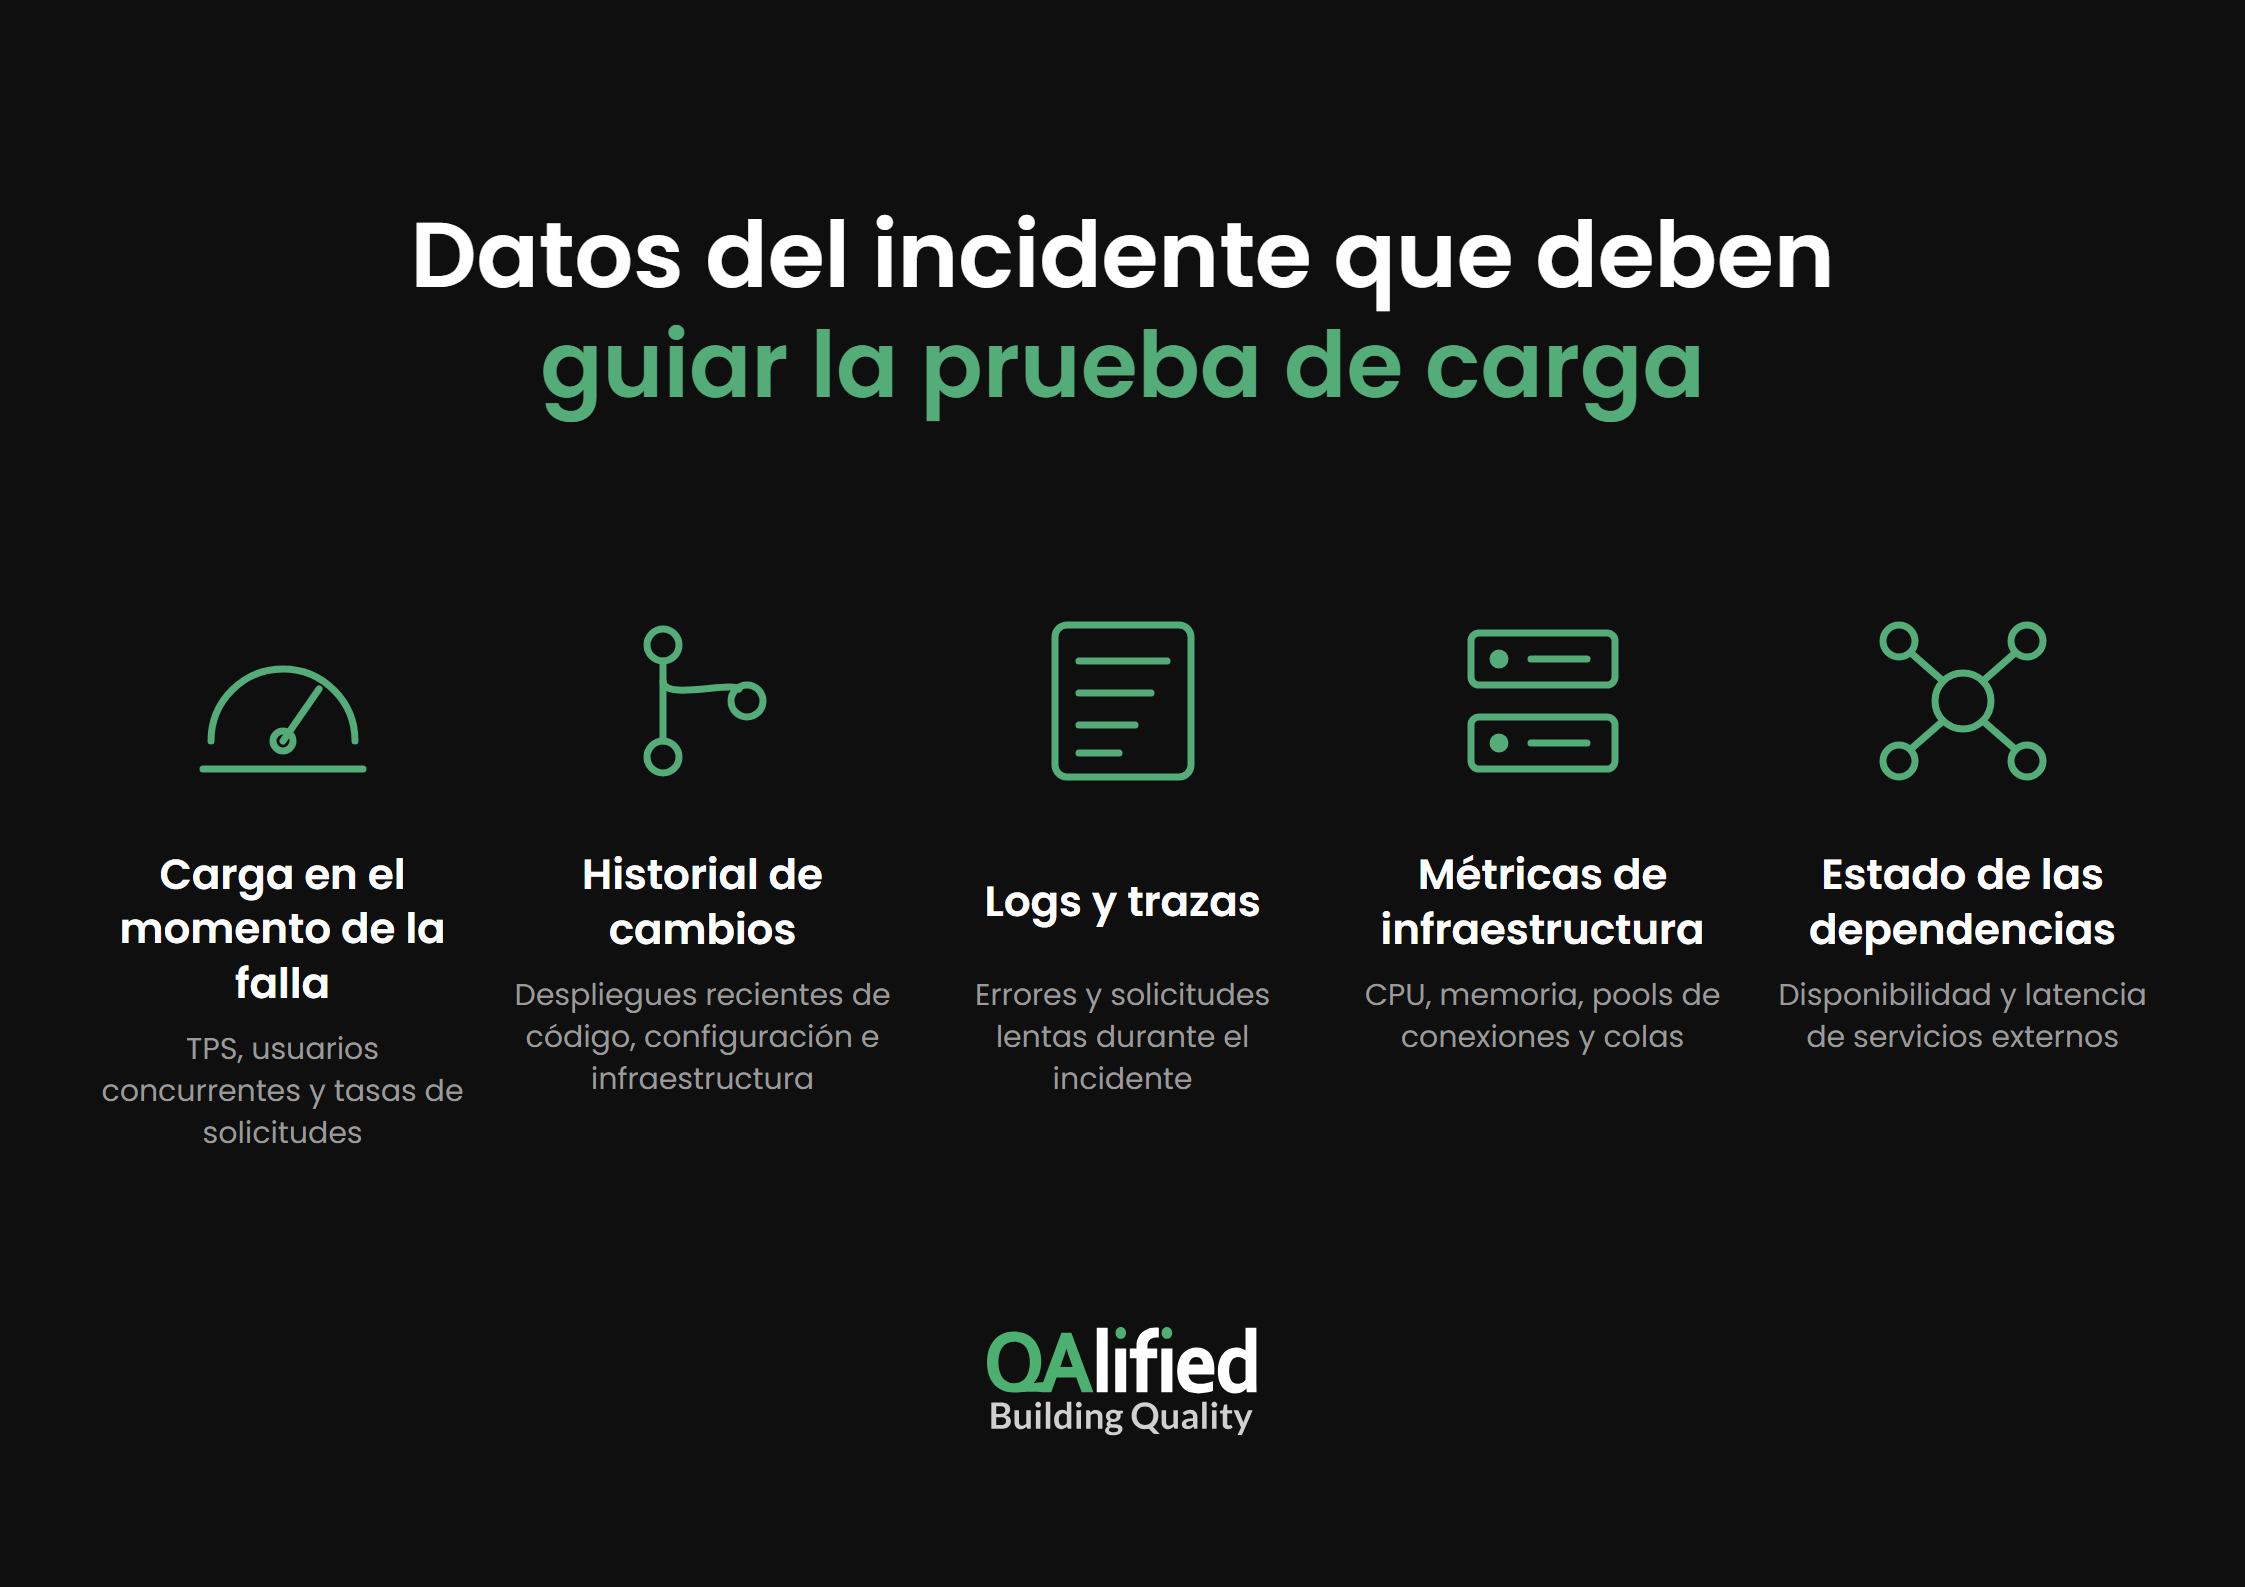
Estos conjuntos de datos nos ayudan a definir un escenario de prueba realista:
- Carga en el momento de la falla: transacciones por segundo (TPS), usuarios concurrentes y tasas de solicitudes.
- Historial de cambios: despliegues recientes de código, configuración e infraestructura.
- Logs y trazas: errores y solicitudes lentas registrados durante la ventana del incidente.
- Métricas de infraestructura: CPU, memoria, pools de conexiones y colas.
- Estado de las dependencias: disponibilidad y latencia de los servicios externos.
Según nuestra experiencia, lo que a los equipos más suele faltarles son los datos de prueba para ejecutar los escenarios y la información precisa sobre la carga a simular, como los TPS y los usuarios concurrentes. Reunir esas cifras temprano evita que la prueba se base en suposiciones.
¿Cómo saber si el incidente estuvo relacionado con la carga?
Para determinar si una falla se debió a la carga, a un cambio de código, a la infraestructura o a una dependencia externa, primero revisamos si hubo un aumento anormal de la carga del sistema o si el problema coincidió con un cambio de código o de infraestructura. Luego, los logs confirman o descartan cada hipótesis.
¿Cómo recrear la carga de trabajo y las transacciones detrás de la falla?
Recrear la carga de trabajo significa traducir los datos del incidente a un escenario de prueba con la misma mezcla de transacciones, concurrencia y tasa de solicitudes observadas durante la falla. El escenario debe reproducir el problema antes de aplicar la corrección, para que ese mismo escenario pueda demostrar después que la corrección funciona.
Elegimos las transacciones a incluir según dos criterios:
- Transacciones críticas para el negocio, que deben seguir funcionando con un rendimiento aceptable.
- Transacciones modificadas por la corrección, ya que cada cambio hecho para resolver el problema introduce un nuevo riesgo.
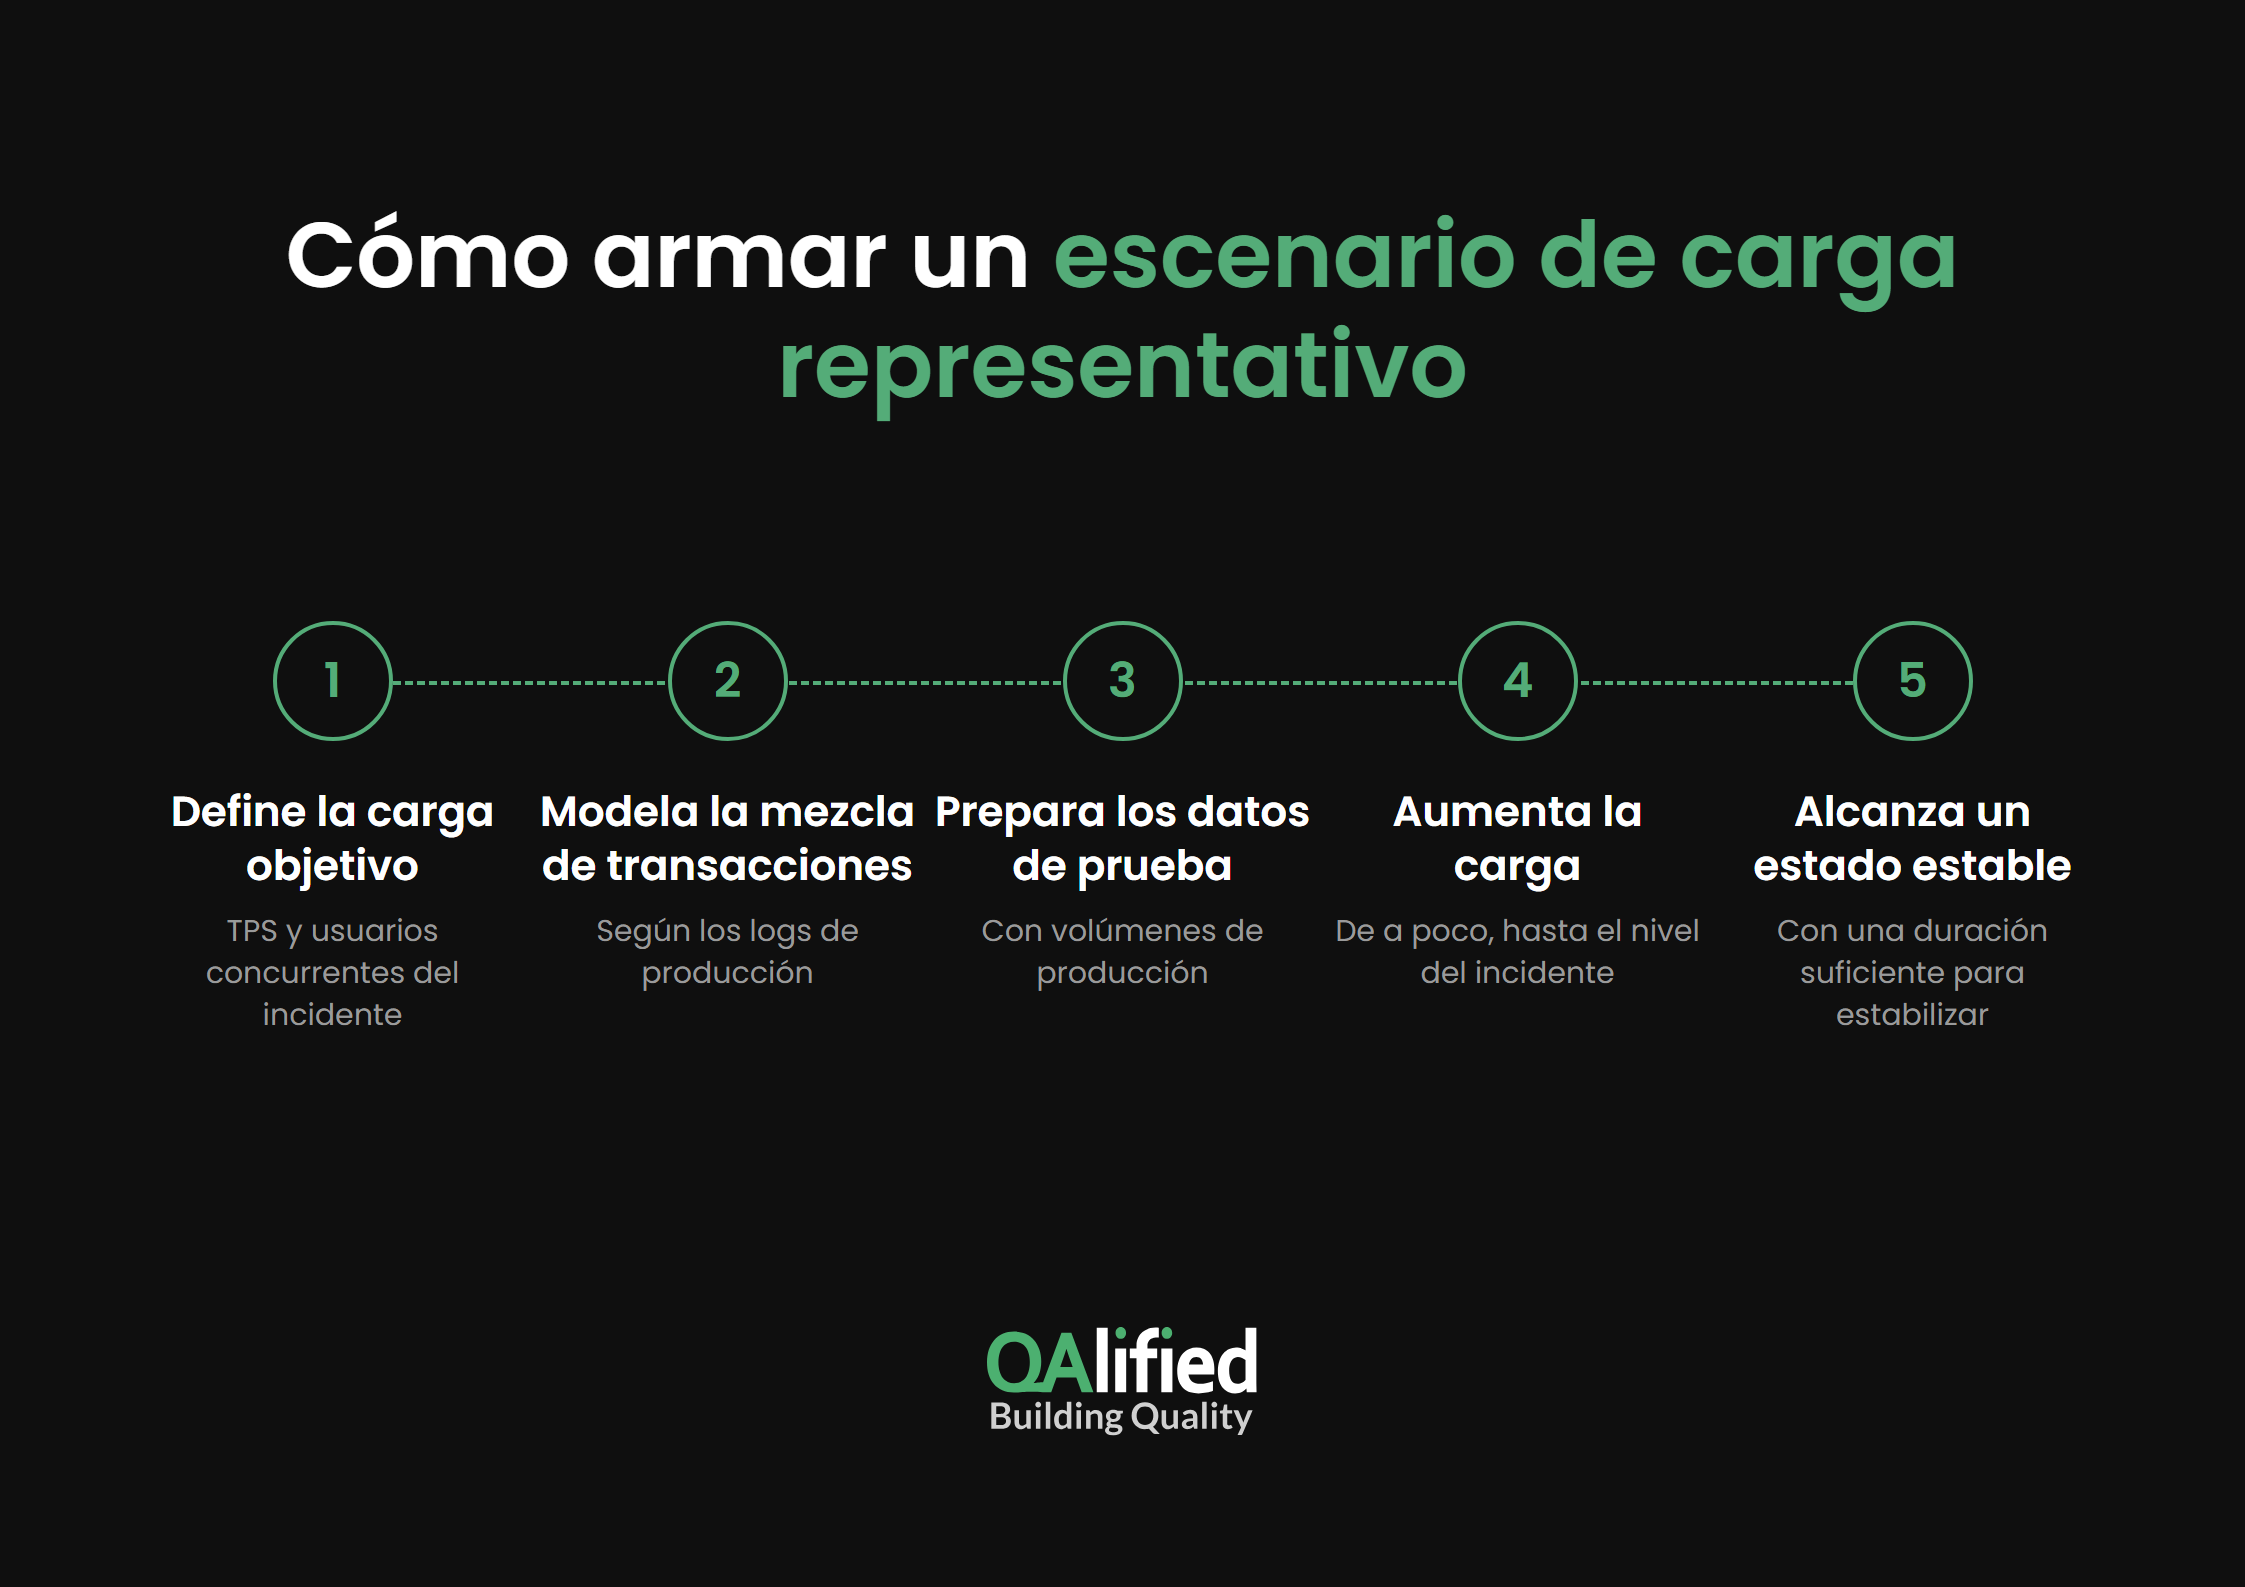
Para construir un escenario representativo, seguimos estos pasos:
- Definir la carga objetivo a partir de los TPS y usuarios concurrentes registrados durante el incidente.
- Modelar la mezcla de transacciones observada en los logs de producción.
- Preparar datos de prueba que reflejen los volúmenes de producción.
- Aumentar la carga de forma gradual, empezando con pocos usuarios hasta llegar al nivel del incidente.
- Fijar una duración suficiente para que el sistema alcance un estado estable.
Las pruebas de carga por sí solas no siempre cubren el riesgo detrás de un incidente. La siguiente tabla resume cuándo las complementamos con otros tipos de prueba:
| Tipo de prueba | Riesgo que modela | Cuándo la usamos |
|---|---|---|
| Prueba de carga | Tráfico esperado o al nivel del incidente | Para reproducir la falla y validar la corrección |
| Prueba de picos (spike) | Picos de uso breves y repentinos | Cuando el riesgo son ráfagas cortas de tráfico durante el día |
| Prueba de resistencia (soak) | Carga sostenida en el tiempo | Cuando la carga puede durar más de 3 o 4 horas |
| Prueba de estrés | Carga por encima de la capacidad normal | Para encontrar el punto de quiebre y el comportamiento de recuperación |
¿Dónde ejecutar las pruebas de rendimiento y qué resguardos se necesitan?
La mayoría de las pruebas de carga posteriores a un incidente deberían ejecutarse en un entorno similar a producción, mientras que las pruebas de rendimiento controladas en producción quedan reservadas para los casos que ningún otro entorno puede reproducir. En ambos casos, el entorno de prueba debe ser lo más parecido posible a producción.
Hay dos diferencias que requieren especial atención. Si el entorno de prueba tiene menos recursos que producción, esa diferencia debe tenerse en cuenta en la carga a simular. Si la arquitectura difiere demasiado, por ejemplo con servicios simulados (mocks) o integraciones faltantes, los resultados pueden no ser válidos para sacar conclusiones.
La siguiente tabla compara ambos enfoques:
| Aspecto | Entorno similar a producción | Pruebas controladas en producción |
|---|---|---|
| Riesgo para usuarios reales | Ninguno | Bajo, con resguardos |
| Fidelidad al incidente | Depende de qué tan parecido sea a producción | Alta |
| Límites de carga | Hasta el punto de quiebre | Por debajo de la capacidad conocida |
| Mejor uso | Reproducir la falla y validar correcciones | Confirmar resultados que un entorno de prueba no puede reproducir |
| Requisito principal | Ajustar por diferencias de recursos y arquitectura | Monitoreo, criterios de detención y un plan de rollback |
Cuando es necesario probar en producción, estos resguardos reducen el riesgo para los usuarios reales:
- Programar las pruebas en ventanas de bajo tráfico.
- Limitar la carga por debajo del nivel que causó el incidente y aumentarla de forma gradual.
- Monitorear las transacciones de los usuarios reales mientras corre la prueba.
- Definir criterios de detención, como umbrales de tasa de error o de tiempo de respuesta.
- Acordar con operaciones un plan de comunicación y de rollback.
¿Qué métricas revelan los cuellos de botella durante las pruebas de carga?
Los cuellos de botella de rendimiento se hacen visibles cuando se analizan en conjunto los tiempos de respuesta, las tasas de error, el throughput y el uso de recursos. Los promedios por sí solos pueden ocultar el problema: un tiempo de respuesta promedio estable puede convivir con una pequeña parte de solicitudes que tardan varios segundos o fallan.
Las métricas que seguimos durante una prueba de carga posterior a un incidente incluyen:
- Percentiles de tiempo de respuesta (p90, p95, p99) de cada transacción.
- Tasa de error por transacción y por tipo de error.
- Throughput, medido en TPS.
- Recursos del servidor de aplicaciones: CPU, memoria y garbage collection.
- Comportamiento de la base de datos: conexiones, consultas lentas y bloqueos.
- Latencia de las dependencias externas.
Correlacionar los resultados de carga con logs, trazas y métricas de infraestructura muestra qué componente se degrada primero a medida que aumenta la carga, y confirma o descarta la causa raíz sospechada.
¿Cómo comparar los resultados y confirmar que las correcciones cumplen los criterios de aceptación?
La forma más confiable de comparar el comportamiento antes y después de una corrección es ejecutar la misma prueba en ambos casos, con el mismo escenario, datos, entorno y carga. Si no existe una medición previa confiable, los logs de producción que registran los tiempos de respuesta reales pueden servir como línea base.
Los criterios de aceptación suelen definirse en conjunto entre el equipo de pruebas de rendimiento y el cliente. El equipo aporta su experiencia en testing, y el cliente, su conocimiento de los usuarios y de las prioridades del negocio.
La siguiente tabla muestra cómo se compara y valida cada criterio:
| Métrica | Antes de la corrección | Después de la corrección | Se valida cuando |
|---|---|---|---|
| Tiempo de respuesta (p95) | Medido con la carga del incidente | Mismo escenario y carga | Cumple el umbral acordado |
| Tasa de error | Medida con la carga del incidente | Mismo escenario y carga | Se mantiene dentro de la tasa aceptable |
| Throughput | TPS máximos sostenidos | Mismo escenario y carga | Sostiene los TPS objetivo |
| Uso de recursos | Picos de CPU, memoria y conexiones | Mismo escenario y carga | Se mantiene dentro de los límites de capacidad |
A veces el tiempo de respuesta mejora mientras aumentan los errores, el consumo de recursos o los costos. En esos casos, nos apoyamos en los criterios de aceptación definidos de antemano: cuando se definen tiempos de respuesta como criterio, normalmente también se definen tasas de error aceptables, de modo que un sistema más rápido pero menos estable no aprueba.
Consideramos que una corrección está validada cuando:
- El escenario de prueba reproduce la carga del incidente.
- Se cumplen todos los criterios de aceptación en ejecuciones repetidas.
- No aparecen nuevos errores ni cuellos de botella de recursos.
- Los resultados quedan documentados para futuras pruebas de regresión.
¿Cómo puede ayudarte QAlified a validar las correcciones de rendimiento después de un incidente?
Validar una corrección de rendimiento requiere pruebas repetibles y evidencia medible. Ejecutar el mismo escenario antes y después de la corrección, en condiciones equivalentes y contra criterios de aceptación acordados, es lo que convierte una recuperación en una solución confirmada.
A través de nuestro servicio de testing de rendimiento, entregamos toda la documentación generada durante el proceso, empezando por el plan de pruebas, junto con los scripts y herramientas auxiliares necesarios para ejecutarlas y un informe final con las ejecuciones, conclusiones y recomendaciones. Tu equipo puede reutilizar esos recursos para prevenir regresiones y, si necesitas acompañamiento continuo, nuestro modelo de pruebas de rendimiento como servicio mantiene esa capacidad activa.
Hablemos sobre tus pruebas de rendimiento después de un incidente. Contáctanos y te ayudaremos a planificar las pruebas de carga después de un incidente y a validar tus correcciones con evidencia.
COMPARTIR EN:
