


Los problemas de rendimiento en aplicaciones se manifiestan como pantallas lentas e inestabilidad en las horas pico. La reacción habitual es optimizar el código que parece culpable o agregar servidores. Sin mediciones, ambas cosas son suposiciones, y los equipos pueden pasar semanas ajustando un componente que nunca fue el cuello de botella.
En QAlified hacemos pruebas de rendimiento para instituciones financieras y otras organizaciones con sistemas críticos. Esta guía sigue el orden que usamos con ellas: síntomas, telemetría, aislamiento, validación y el punto en el que conviene buscar ayuda externa.
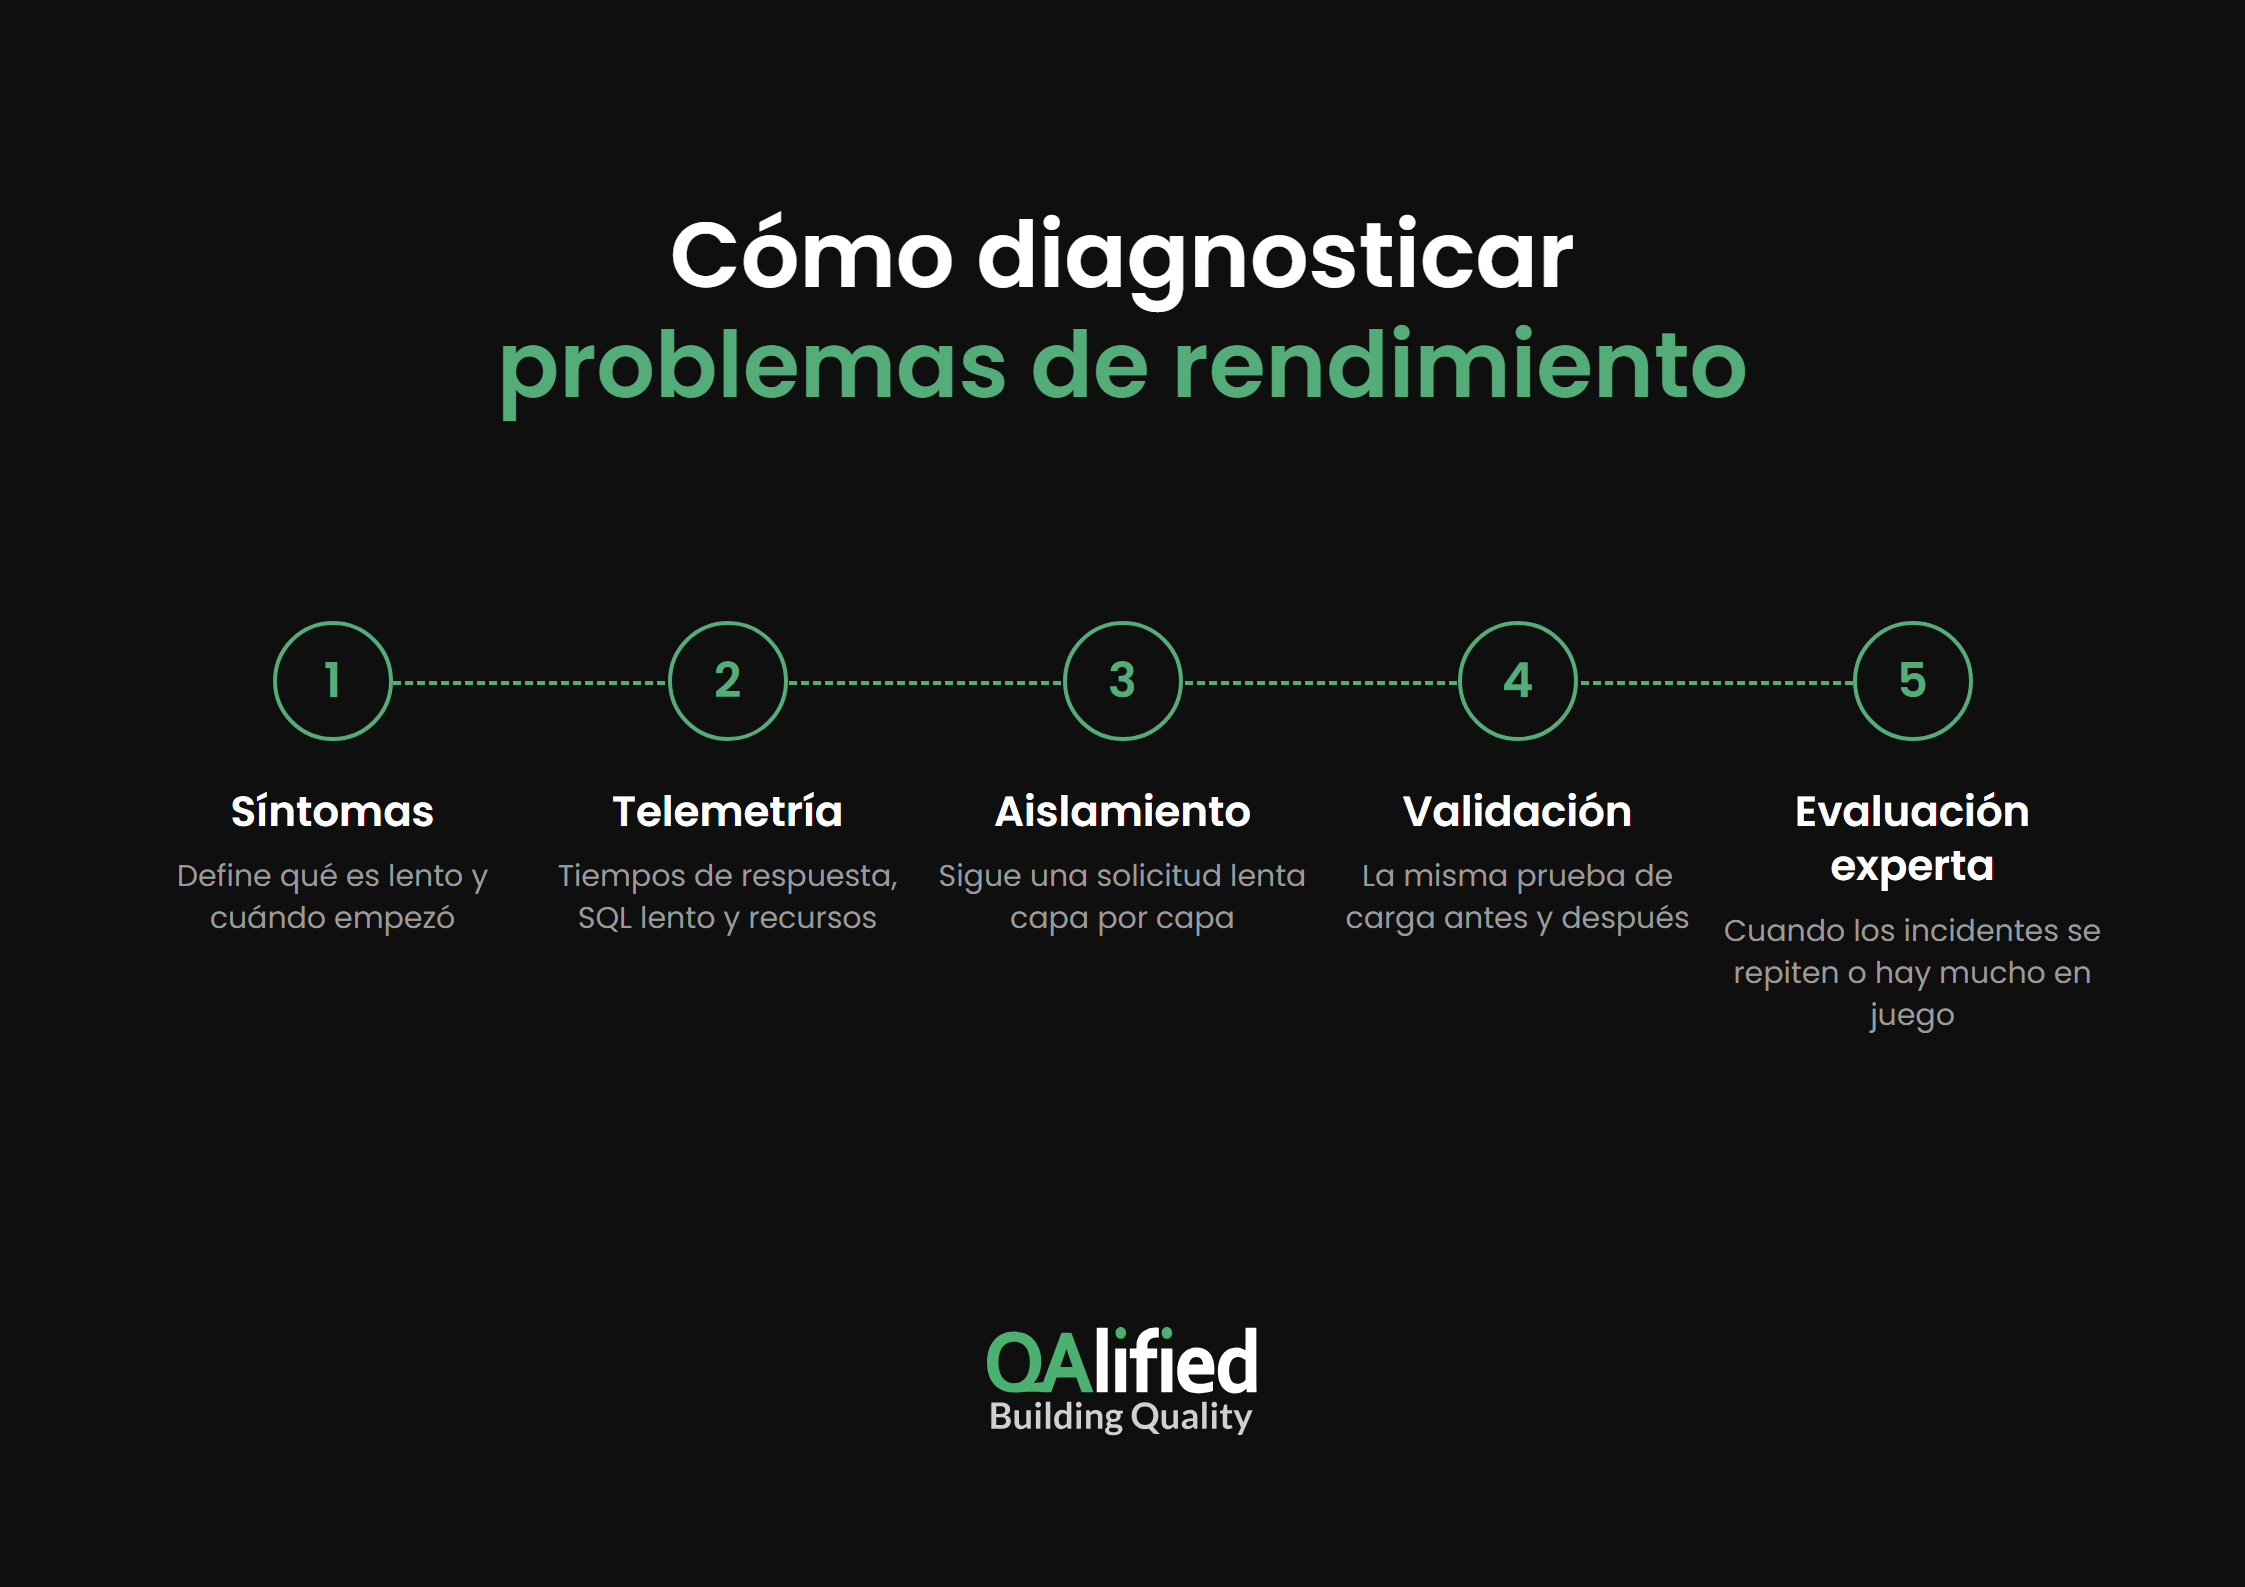
Para diagnosticar problemas de rendimiento en aplicaciones, primero define el problema y después mide. Compara los tiempos de respuesta, las sentencias SQL lentas y el uso de recursos de los servidores con una línea base histórica, recorre el camino de la solicitud hasta encontrar la capa que agrega la demora y confirma la causa con una prueba de carga repetible antes de cambiar nada.
En resumen
- Define qué significa «lento», cuándo empezó y cuándo el problema se considera resuelto.
- Revisa el tiempo de respuesta total, las sentencias SQL más lentas y el uso de recursos de los servidores, y lee percentiles en lugar de promedios.
- Sigue una solicitud lenta a través del frontend, las APIs, la base de datos, la infraestructura y los servicios externos hasta que aparezca la demora.
- Reproduce la carga real con una prueba representativa y ejecuta la misma prueba antes y después de cada corrección.
- Solicita una evaluación profesional cuando los incidentes se repiten, la causa sigue sin estar clara o se acerca un lanzamiento con alta carga o una migración crítica.
¿Qué síntomas indican problemas de rendimiento en aplicaciones en producción?
El primer síntoma de un problema de rendimiento en producción es la lentitud general y la inestabilidad en las horas pico. Los usuarios notan pantallas lentas y un sistema que se comporta distinto según la hora del día.
¿Cómo distinguir la lentitud de los errores funcionales que solo aparecen con concurrencia?
Un error funcional que aparece solo bajo ciertas condiciones, principalmente de concurrencia, es un problema distinto de uno de rendimiento y requiere una solución diferente. Separar ambos antes de empezar a optimizar evita que el equipo trabaje sobre la causa equivocada.
¿Qué preguntar cuando alguien reporta lentitud?
Un reporte de lentitud es solo un punto de partida. Cinco preguntas convierten un reporte en algo que se puede diagnosticar:
- ¿La lentitud afecta a todo el sistema o solo a pantallas específicas?
- ¿Es constante durante todo el día o se concentra en ciertas franjas horarias?
- ¿Qué significa «lento» y se midieron esos tiempos de respuesta?
- ¿Cuándo empezó?
- ¿El sistema muestra algún error en algún momento o solo está lento?
¿Qué transacciones investigar primero en un diagnóstico de rendimiento?
Prioriza las transacciones según su criticidad para el negocio y la gravedad de los problemas encontrados. Una confirmación de pago lenta que usan todos los clientes tiene prioridad sobre un reporte lento que abren dos analistas una vez al mes.
¿Qué métricas, logs y trazas revisar primero?
Empieza por el tiempo de respuesta total y el tiempo de respuesta de las sentencias SQL más lentas, respaldados por el análisis del uso de recursos de los servidores y por los logs de acceso, que vinculan cada solicitud lenta con lo que estaba haciendo la infraestructura en ese momento.
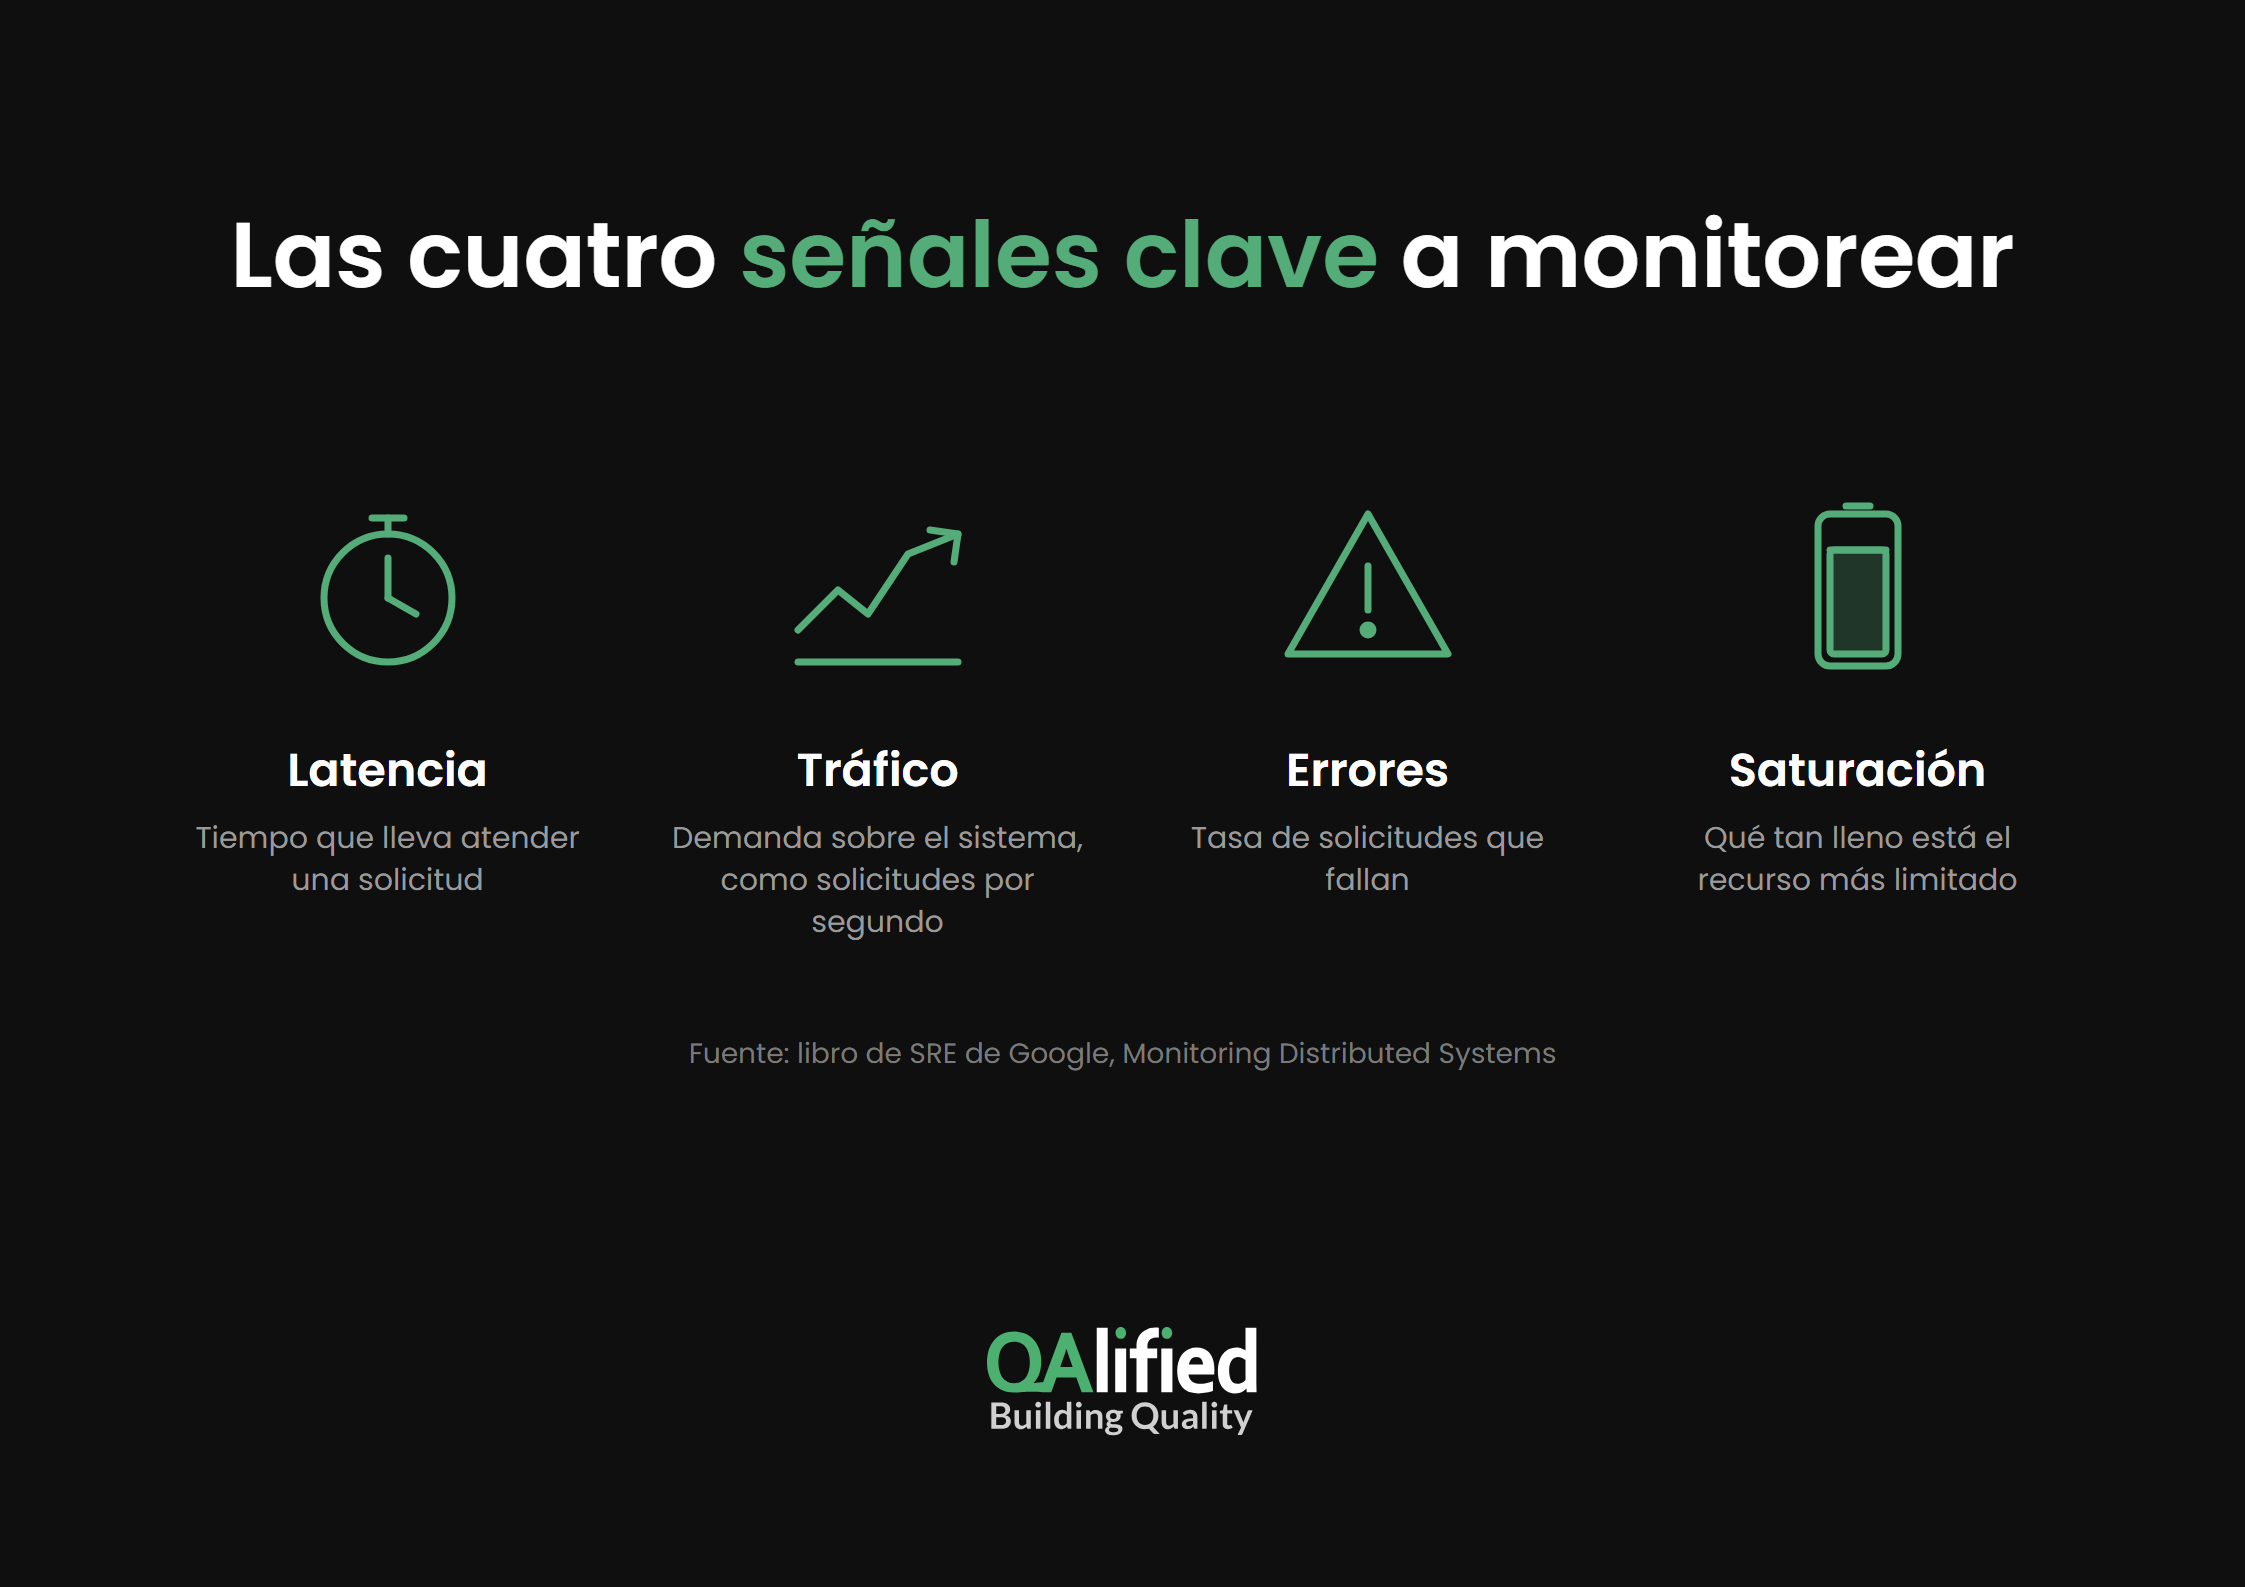
El libro de SRE de Google define cuatro señales a medir en cualquier sistema que atiende usuarios:
- Latencia: el tiempo que lleva atender una solicitud.
- Tráfico: la demanda que recibe el sistema, como las solicitudes por segundo.
- Errores: la tasa de solicitudes que fallan.
- Saturación: qué tan lleno está el recurso más limitado.
¿Por qué el tiempo de respuesta promedio puede ocultar el problema?
Un promedio mezcla solicitudes rápidas y lentas en un solo número, por lo que los extremos desaparecen: los tiempos muy altos que perjudican a algunos usuarios y los muy bajos que hacen bajar la media.
El libro de SRE da el ejemplo de un servicio con una latencia promedio de 100 ms en el que el 1% de las solicitudes todavía puede tardar 5 segundos. En su lugar, sigue percentiles como el 99 y la distribución de los tiempos de respuesta. Un percentil 99 en aumento también puede ser una señal temprana de saturación.
¿Cómo comparar el comportamiento actual con la línea base habitual?
Mantén un registro histórico de los tiempos de respuesta y del tráfico. Si no hay herramientas de observabilidad instaladas, los logs de acceso aportan las mismas estadísticas. Una vez que encuentres el momento en que empezó la degradación, relaciónalo con cambios como un release de código, una actualización de configuración o un aumento del tráfico.
¿Cómo aislar los cuellos de botella de rendimiento en las capas de la aplicación?
Un cuello de botella puede estar en el frontend, las APIs, la base de datos, la infraestructura o un servicio externo. La tabla muestra la señal que apunta a cada capa y la verificación que lo confirma.
| Capa | Señal | Cómo confirmarlo |
|---|---|---|
| Frontend | El servidor responde rápido, pero la pantalla tarda en cargar para el usuario final | Compara el tiempo de respuesta del servidor con el tiempo que el usuario espera hasta ver la pantalla cargada |
| APIs | Una solicitud pasa la mayor parte del tiempo dentro de una llamada a un servicio | Sigue la traza de la solicitud y mide el tiempo de cada llamada |
| Base de datos | Las sentencias SQL tardan en responder | Revisa las sentencias SQL más lentas y busca bloqueos como deadlocks |
| Infraestructura | Los recursos de los servidores están saturados durante los períodos de lentitud | Revisa el uso de recursos de los servidores en el momento de las solicitudes lentas |
| Servicio externo | El código hace llamadas síncronas y secuenciales a terceros que responden lento | Mide cada llamada a terceros por separado del resto de la solicitud |
¿Cómo es un drill-down en la práctica?
Un drill-down sigue la traza de una solicitud con un tiempo de respuesta alto y mide cuánto tarda en responder cada punto de la infraestructura.
Si el servidor responde rápido pero la pantalla tarda en aparecer para el usuario final, el problema está en el frontend. Si las consultas SQL tardan en responder, el cuello de botella es la base de datos.
¿Cuándo agregar recursos no resuelve la causa?
Es común que los equipos dediquen tiempo a optimizar un fragmento de código que creen que genera la lentitud, sin las mediciones necesarias para confirmar esa teoría.
Agregar recursos no sirve ante bloqueos de base de datos como los deadlocks, ni ante código que hace llamadas síncronas y secuenciales a servicios de terceros lentos. Frente a esas causas, más CPU o más servidores no cambian el tiempo de espera.
¿Cómo pueden las pruebas de rendimiento y de carga en producción confirmar los hallazgos?
Una prueba de carga convierte los hallazgos de producción en un experimento controlado que confirma o descarta la causa sospechada.
¿Qué datos se necesitan para armar un escenario de carga representativo?
Las estadísticas de producción definen el escenario. Un escenario representativo necesita, por ejemplo, la cantidad de transacciones por segundo, las transacciones a incluir en la prueba y el volumen de datos que hoy tiene la base de datos de producción.
¿La prueba debe ejecutarse en un entorno similar a producción o en producción?
Algunas arquitecturas son demasiado complejas para replicarlas en preproducción por sus múltiples interacciones con otros sistemas. En esos casos, recomendamos probar directamente en producción con estos controles:
- Ejecuta las pruebas fuera del horario de atención, cuando el sistema tiene un horario de uso definido.
- Haz un respaldo de la base de datos que las pruebas van a impactar.
- Avisa a los usuarios que el sistema estará en mantenimiento durante las pruebas, cuando sea posible.
¿Qué evidencia demuestra que una corrección funcionó?
La mejor evidencia es comparar los resultados de la misma prueba antes y después de la corrección. Si la corrección resolvió el problema, deberían mejorar los tiempos de respuesta, el uso de recursos o la métrica que haya expuesto el problema.
La comparación antes y después solo funciona si el equipo definió primero el problema y cómo se ve resuelto, por ejemplo un tiempo de respuesta objetivo para una transacción concreta.
¿Cuándo se necesita una evaluación profesional de rendimiento?
Una evaluación profesional tiene sentido cuando lo que está en juego ante una falla de rendimiento es alto o cuando las mediciones internas no logran aislar la causa.
¿Qué señales muestran que una empresa necesita una evaluación profesional de rendimiento?
Algunas situaciones que justifican una evaluación profesional de rendimiento son un sistema nuevo a punto de salir a producción con una carga esperada alta, la migración de un sistema crítico para el negocio y un rendimiento deficiente que ya empezó a costarle clientes a la empresa.
¿Qué debe preparar y recibir una empresa en una evaluación de rendimiento?
Antes de empezar, la empresa necesita una lista clara de los problemas que tiene hoy, o de los que espera tener cuando el sistema se abra al público general.
Al final, debería recibir la información necesaria para tomar decisiones, como los resultados de las pruebas, las conclusiones y las recomendaciones.
¿Cómo diagnosticó un banco la lentitud de su plataforma de home banking?
El proyecto de home banking de Bancop muestra la secuencia desde el síntoma hasta la intervención:
- Síntoma: el banco reportó lentitud e inestabilidad en operaciones en tiempo real, como consultas de movimientos, transferencias, pagos a proveedores y pagos de salarios.
- Causa sospechada: un cuello de botella en algún componente de la arquitectura, sin mediciones que lo confirmaran.
- Prueba: un escenario de carga representativo construido con Apache JMeter para web y mobile (Android e iOS), escalado hasta 400 usuarios concurrentes en los flujos de mayor actividad.
- Monitoreo: seguimiento de los recursos de infraestructura junto con el equipo del banco durante la prueba.
- Cuello de botella encontrado: el servidor de aplicaciones y la base de datos.
- Intervención: ajustes en esos componentes y recomendaciones para la escalabilidad futura.
- Resultado: el banco evaluó sus operaciones más críticas bajo carga, aplicó los ajustes y recibió una transferencia de conocimiento sobre la herramienta y los scripts para evolucionar las pruebas por su cuenta.
Preguntas frecuentes
1. ¿Cómo se define cuándo un problema de rendimiento está resuelto?
Un problema se considera resuelto cuando una métrica acordada alcanza su objetivo en las mismas condiciones que lo expusieron. Primero escribe el enunciado del problema: qué transacción, bajo qué carga y qué tiempo de respuesta o uso de recursos es aceptable. Luego ejecuta la misma prueba antes y después de la corrección y compara los resultados.
2. ¿Por qué importa el volumen de datos de la base de producción en una prueba de carga?
Un escenario de carga representativo necesita el volumen de datos que hoy tiene la base de datos de producción. Los tiempos de las consultas dependen de cuántos datos tienen las tablas, por lo que una prueba contra una base pequeña puede parecer rápida y ocultar las sentencias SQL lentas que sufren los usuarios en producción.
¿Cómo podemos ayudarte a diagnosticar y resolver problemas de rendimiento en aplicaciones?
Un diagnóstico empieza por definir el problema con exactitud y el punto en el que se considera resuelto. Después viene el análisis que ubica el cuello de botella principal, con una medición en cada paso. Medir antes de optimizar mantiene el trabajo enfocado en la capa donde está la demora.
Nuestro equipo diseña escenarios de carga y valida las correcciones con pruebas repetibles a través de nuestro servicio de Performance Testing as a Service. Si tu aplicación se pone lenta en las horas pico o los mismos incidentes vuelven a aparecer, cuéntanos qué estás viendo y te ayudaremos a planificar el diagnóstico.
COMPARTIR EN:
